
Monitoramento à prova de falhas — como garantir isso com clusters de servidores
Monitoramento à prova de falhas — como garantir isso com clusters de servidores
As redes de computadores já são parte crítica dos processos de negócio. A falha desse sistema, na prática, para a atividade da organização. Monitorar e diagnosticar o desempenho da rede é uma das tarefas principais para manter a empresa em funcionamento. É um processo contínuo: detectar falhas e erros a tempo e responder rápido. Por isso surge a questão da alta disponibilidade do próprio serviço de monitoramento e da operação sem interrupção.
O 10-Strike Network Monitor Pro traz vários mecanismos de tolerância a falhas do sistema de monitoramento. Com eles, a infraestrutura de rede fica sob controle confiável. Veja os métodos disponíveis, até o cluster de failover dos servidores de monitoramento.
Guardião do serviço de monitoramento
O watchdog do servidor de monitoramento é o serviço 10-Strike Network Monitor Watchdog. Ele é instalado em cada host que recebe o pacote principal ou o pacote do servidor de monitoramento. O serviço acompanha o 10-Strike Network Monitor Pro Service e o SGBD Firebird Server. Se esses serviços param ou caem, o guardião os reinicia. Depois de cinco tentativas sem sucesso, ele envia um e-mail ao endereço configurado. Mesmo se você parar o serviço de monitoramento de propósito, para manutenção do banco, o guardião ativo o sobe de novo em poucos segundos. Nesses casos, pare primeiro o watchdog e só depois o servidor de monitoramento.
O watchdog acompanha não só o estado do serviço (iniciado / não iniciado), mas também a atividade do processo de monitoramento e os parâmetros. Se o processo deixa de dar sinal de atividade (gravar uma marca no banco), o guardião também reinicia o serviço. O mesmo ocorre se um certo número de verificações deixa de ser executado, o que pode indicar acúmulo de erros internos.
O watchdog evita que o monitoramento pare por erros de software no servidor de monitoramento.
Servidor de banco reserva
No sistema distribuído, o banco central fica em um servidor físico, e os servidores de monitoramento costumam ficar em outros. Os serviços conectam ao banco por TCP, recebem as configurações e gravam estatísticas e resultados. O servidor de banco pode falhar, ou a conexão pode cair. Isso ameaça a informação operacional que o servidor de monitoramento grava no banco.

A saída é um servidor reserva com o banco instalado, para o qual o sistema de arquivos inteiro (ou parte dos arquivos) é replicado. Nas configurações do serviço há um parâmetro com o endereço do servidor de banco reserva. O servidor de monitoramento e a console gráfica passam para ele automaticamente se o banco principal ficar indisponível. O endereço do reserva fica nas configurações de conexão do banco. A replicação do banco (por exemplo, o espelhamento do sistema de arquivos) precisa ser configurada à parte, para a cópia reserva permanecer atualizada.

Proteção contra perda de informação quando a conexão com o banco central cai
Há uma alternativa para a perda de conexão entre o servidor de monitoramento remoto e o banco central. Se o servidor de banco reserva não estiver configurado, o serviço passa para o banco local, instalado automaticamente pelo pacote (c:\ProgramData\10-Strike\Network Monitor Pro\LocalDB\NETMONITOR.FDB ). As estatísticas dos hosts ficam nesse banco local até a comunicação com o banco principal voltar. Quando a conexão retorna, os dados acumulados nesse período são transferidos automaticamente para o banco principal. O processo é automático e não exige ação do usuário nem configuração extra.

Nessas situações, o log do serviço vai para o log do programa (c:\ProgramData\10-Strike\Network Monitor Pro\Logs\NetMonitorPro.log). Se a conexão com o banco ficar interrompida por muito tempo, dá para conferir nesse log se os dados foram transferidos ao banco central.
Reserva do servidor de monitoramento — trabalho com o servidor secundário
A reserva vale não só para o banco central, mas também para o próprio servidor de monitoramento. Se o host do serviço de monitoramento falha, o monitoramento para por completo. Para evitar isso, instale um servidor de monitoramento reserva em um segundo host físico e dê a ele o mesmo ID. Ficam dois serviços ativos, ligados ao mesmo banco e com o mesmo ID no arquivo de configuração c:\ProgramData\10-Strike\Network Monitor Pro\NetMonitorPro.ini. O serviço que inicia primeiro fica ativo e executa todas as verificações. O que inicia depois vira reserva: lê a mesma lista no banco, mas não executa as verificações. O reserva acompanha a atividade do primeiro por indicadores do banco. Se o primeiro deixa de estar ativo, o reserva passa a executar as verificações, sem interrupção.
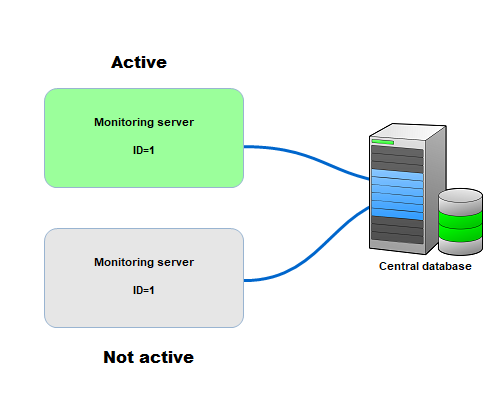
Quando o primeiro servidor volta ao normal, o primeiro serviço assume o papel de reserva e passa a acompanhar a atividade do segundo. E assim por diante.
Esta solução serve para montar um cluster de failover de servidores.