 Hoje, perder dados importantes pode ser pior do que perder um bem físico. Em alguns casos, o negócio para por causa da perda de dados vitais. O motivo costuma ser a falha súbita da mídia de armazenamento. Essas falhas nem sempre são súbitas. Discos rígidos costumam falhar pela degradação lenta das peças mecânicas e dos pratos magnéticos. Como uma pessoa, o disco pode "passar mal" por um bom tempo antes de parar de vez. O administrador precisa observar os sinais de falha iminente para trocar o disco a tempo, depois de copiar os dados para uma mídia saudável.
Neste artigo
- Métodos de diagnóstico do estado e da saúde do disco
- Como configurar o monitoramento de saúde e estado de HDD/SSD
- Monitoramento SMART de HDD e atributos importantes
- Monitoramento de SSD NVMe e principais atributos de saúde
- Monitoramento de SSD SATA e principais atributos de saúde
- Widgets com resultados de SSD no mapa gráfico
- Vídeo
- Conclusão
Métodos de diagnóstico do estado e da saúde do disco
Os discos rígidos fazem autodiagnóstico. Essa capacidade se chama S.M.A.R.T. (Self-Monitoring, Analysis, and Reporting Technology). Os primeiros padrões foram definidos em conjunto pelos grandes fabricantes em 1995. Desde então, a tecnologia S.M.A.R.T. evoluiu bastante. Cada fabricante define o conjunto de atributos S.M.A.R.T. que considera importante. Acompanhar esses atributos aumenta a confiabilidade do sistema. Quando o disco liga, ele passa a verificar e atualizar os atributos automaticamente. Os valores ficam em uma área especial do disco, acessível só pelo firmware. Cada fabricante também define limites que, em condições normais, não devem ser ultrapassados.
Entre outras tarefas, o administrador precisa conferir com regularidade os atributos SMART críticos e garantir que eles permaneçam em limites seguros. Há aplicativos que leem esses atributos e os mostram de forma clara. Na rotina, porém, é fácil esquecer a verificação e perder o início de uma situação crítica, como:
- temperatura crítica
- aumento exponencial de erros de leitura/gravação
- erros de seek
- setores realocados
Por isso, recomendamos um sistema de monitoramento que verifique os atributos SMART 24 horas por dia e avise na hora sobre qualquer situação anormal.
Os SSDs (e SSDs NVMe) expõem um conjunto um pouco diferente de parâmetros. Ao contrário do HDD, o SSD não realoca setores e não tem problemas de superfície. O principal indicador de saúde é a vida útil. O número total de gravações é limitado. Por isso, acompanhe o uso do SSD e confira se a porcentagem de vida útil consumida permanece abaixo do limite permitido.
No SSD, você pode monitorar estes parâmetros de saúde:
- reserva disponível
- porcentagem usada
- temperatura
- leituras/gravações
- contagem de erros
- aviso crítico (modo somente leitura e outros)
Como configurar o monitoramento de saúde e estado de HDD/SSD
O 10-Strike Network Monitor Pro é um software de uso amplo e monitora muitas coisas, inclusive atributos SMART de HDD, SSD e NVMe. Instale-o em um dos servidores e os agentes nos computadores cujos discos você quer acompanhar. Depois, o Network Monitor varre a rede, encontra os hosts disponíveis e os coloca na lista. Crie a verificação S.M.A.R.T. nos hosts com o agente; ela roda em intervalos regulares, de alguns segundos a várias horas. O núcleo de monitoramento compara os valores de cada agente com os limites. Se o limite é ultrapassado, o Network Monitor avisa por SMS, e-mail e outros meios.
É simples criar uma verificação S.M.A.R.T. dos atributos de saúde do disco. Faça o seguinte:
• Instale o 10-Strike Network Monitor Pro.
• Instale o agente do Network Monitor em cada host cujo disco você quer monitorar. O agente é um serviço do Windows que lê os atributos S.M.A.R.T. e os envia ao núcleo de monitoramento.
• Abra o Network Monitor e faça uma varredura da rede, ou adicione os hosts manualmente.
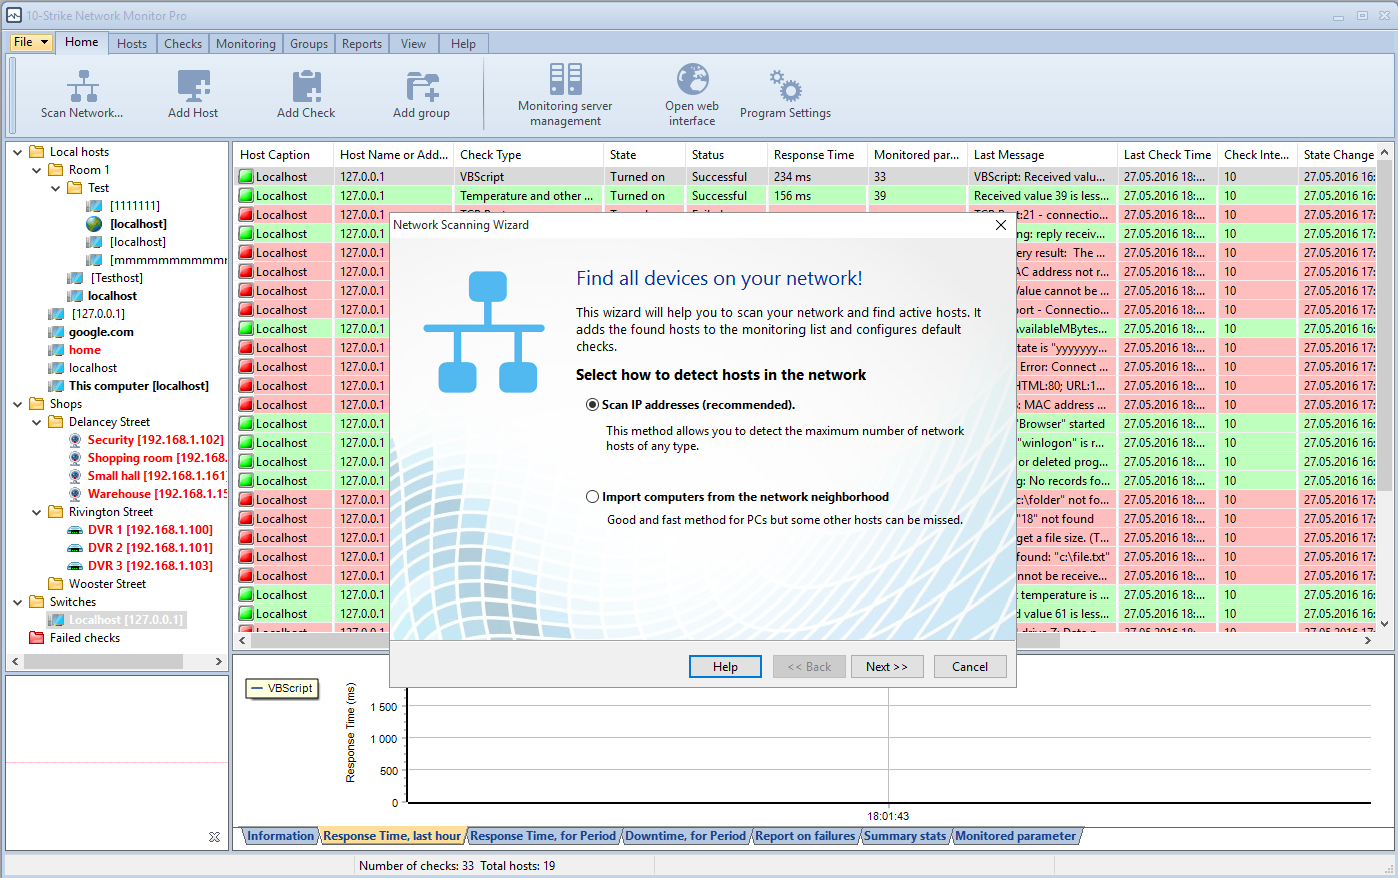
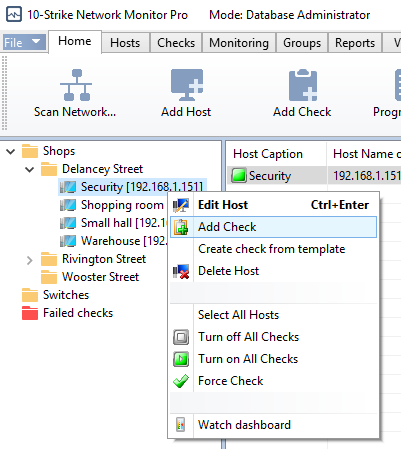
• Selecione o host na árvore (à esquerda) e escolha Add check no menu de contexto.
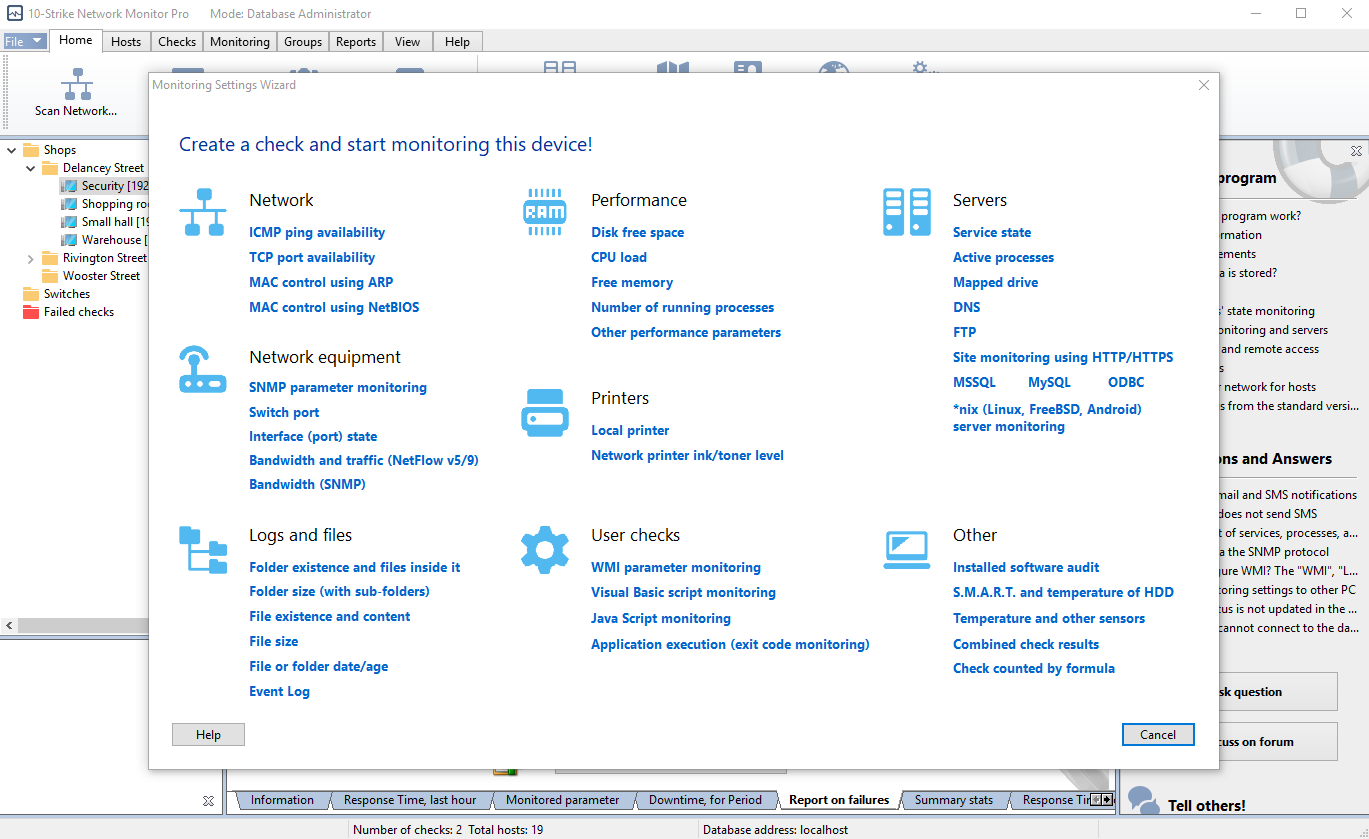
• Na caixa de diálogo Check parameters, escolha o tipo de verificação (S.M.A.R.T.). Depois, clique no botão "..." à direita da lista Hard drive e selecione o disco rígido ou o SSD.
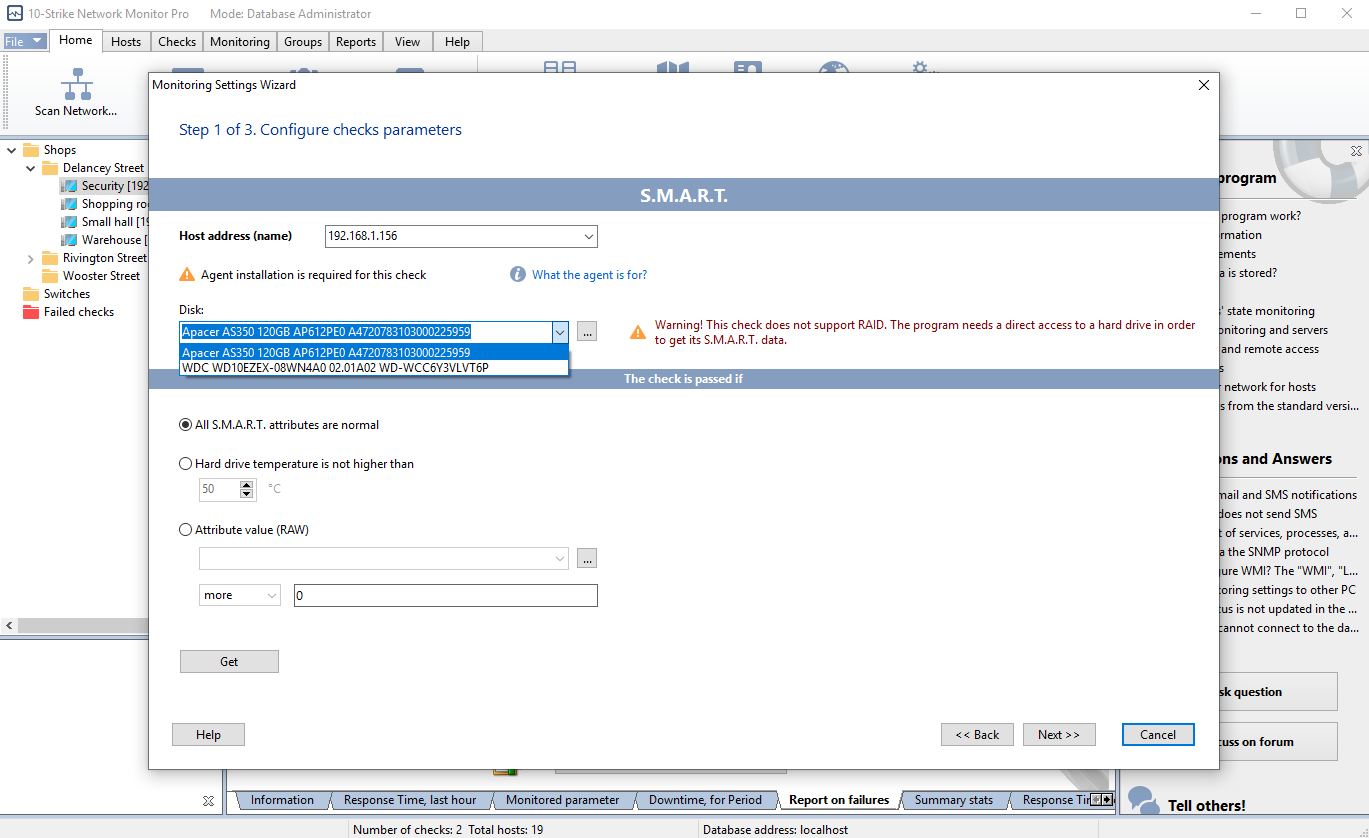
• Selecione o atributo S.M.A.R.T. que você quer monitorar (por exemplo, Temperature ou Seek Error Rate). Clique no botão "..." à direita da lista Attribute value (RAW) e escolha o nome na lista.
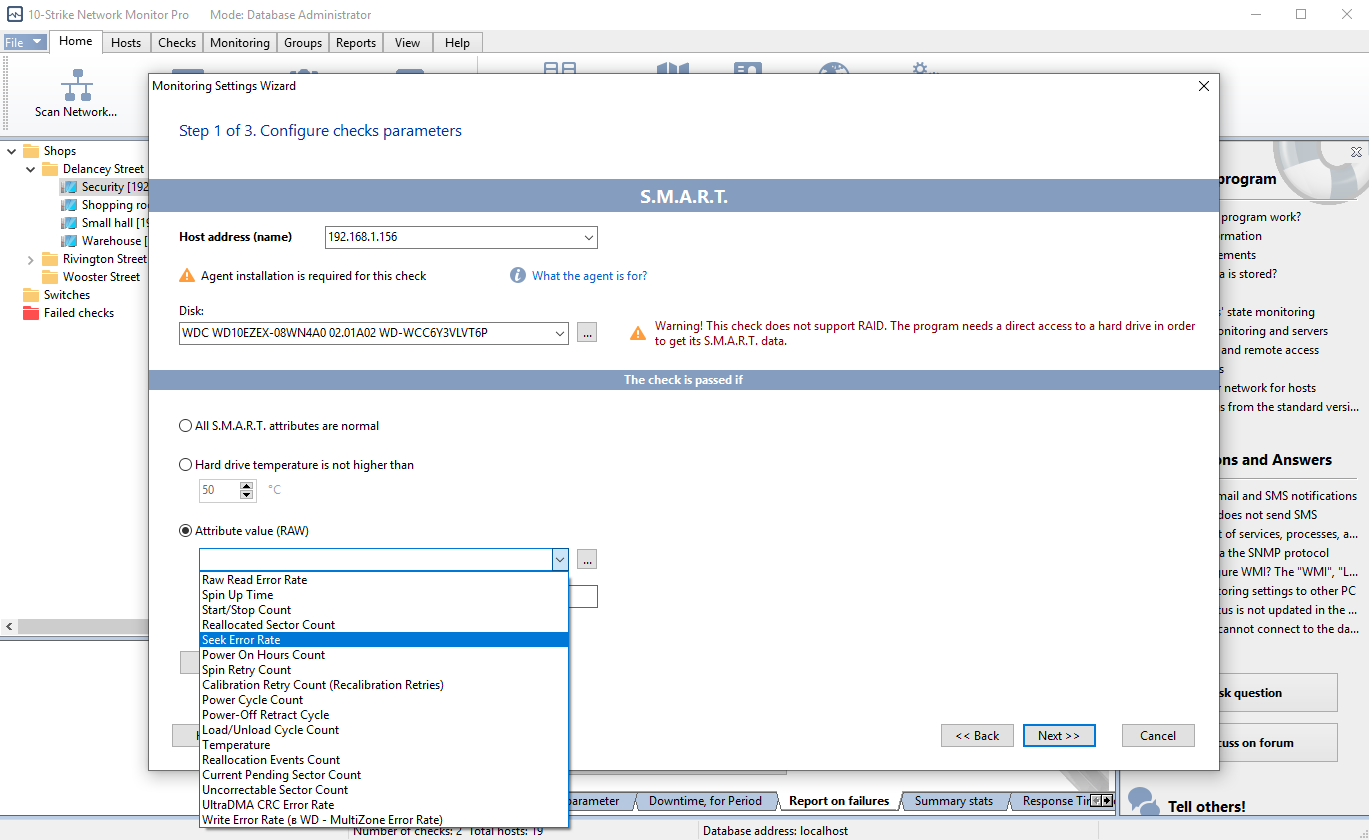
• Defina as condições do alarme (por exemplo, "The check is successful if the attribute value is less than 50").
• Defina os parâmetros de início da verificação ou mantenha os padrão. Configure as notificações e salve as alterações.
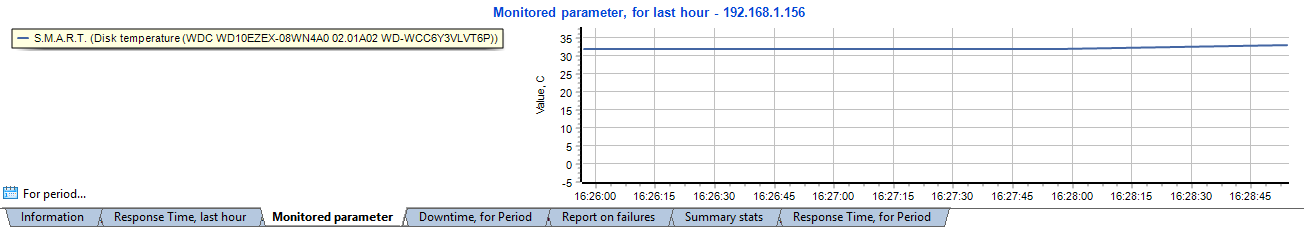
Assim que você adiciona a verificação, ela começa a coletar dados. Acompanhe o processo na aba Monitored parameter (a aba na parte de baixo da janela). O Network Monitor exibe o gráfico do atributo S.M.A.R.T. escolhido.
Monitoramento SMART de HDD e atributos importantes
Abaixo estão os atributos S.M.A.R.T. mais importantes para monitorar em HDD. A escolha depende da mídia. Um SSD não oferece o mesmo conjunto de atributos de um disco rígido.
· #01 Raw Read Error Rate — taxa de erros de leitura de hardware ao ler dados do prato magnético.
· #03 Spin-Up Time — tempo médio de spin-up do eixo. O aumento do valor indica desgaste mecânico (por exemplo, mais atrito no rolamento) ou alimentação inadequada (por exemplo, queda de tensão toda vez que o eixo começa a girar).
· #05 Reallocated Sectors Count — número de setores defeituosos realocados automaticamente pelo firmware do disco. A cada erro de leitura/gravação, o firmware marca o setor como remapeado e transfere os dados para a área reservada. O valor bruto é o total de setores realocados. Quanto maior, pior a superfície do prato.
· #07 Seek Error Rate — taxa de erros de seek das cabeças magnéticas. O aumento indica superfície do prato em mau estado ou falha parcial do sistema mecânico de posicionamento. Também pode vir de superaquecimento ou vibração externa (por exemplo, de outros discos no mesmo computador).
· #10 Spin-Up Retry Count — número de tentativas repetidas de spin-up. O aumento indica problema no subsistema mecânico do disco.
· #196 Reallocation Event Count — número de operações de remapeamento. É o total de tentativas de transferir dados de setores defeituosos para a área reservada (em geral pequena, apenas alguns milhares de setores). Contam tentativas bem-sucedidas e malsucedidas.
· #197 Current Pending Sector Count — número de setores instáveis que precisam ser remapeados por erros de leitura irrecuperáveis. Esses setores ainda não foram marcados como defeituosos, mas a leitura é pouco confiável (pode exigir várias tentativas). Se um setor instável for lido com sucesso depois, ele volta a ser considerado bom; caso contrário, o firmware tenta remapear.
· #198 Uncorrectable Sector Count — total de setores que não podem ser lidos nem gravados. O aumento indica defeitos graves na superfície do prato ou problemas no subsistema mecânico.
· #220 Disk Shift — distância em que os pratos magnéticos se deslocaram em relação ao eixo. O problema vem, na maior parte, de um choque mecânico. Um aumento grande significa que o disco está inutilizável.
Monitoramento de SSD NVMe e principais atributos de saúde
O conjunto de parâmetros S.M.A.R.T. dos SSDs NVMe é diferente do dos discos ATA. Na maior parte dos casos, são indicadores prontos, sem limites e sem valores de pior caso. Este é um exemplo de atributos SMART de um SSD WD Blue SN500 M.2:
critical_warning: 0
temperature: 39
available_spare: 100
available_spare_threshold: 10
percentage_used: 1
data_units_read: 13733602
data_units_written: 14396473
host_reads: 365745477
host_writes: 391133456
controller_busy_time: 836
power_cycles: 1419
power_on_hours: 4612
unsafe_shutdowns: 13
media_errors: 0
num_err_log_entries: 1
warning_temp_time: 0
critical_comp_time: 0
Entre esses parâmetros, os mais úteis são:
critical_warning
Parâmetro que indica o estado do disco:
- valor 0 — o disco está em ordem
- bit 0 (1) — a reserva disponível está abaixo do limite
- bit 1 (2) — a temperatura ultrapassou o limite
- bit 2 (4) — a confiabilidade caiu por excesso de erros de mídia ou internos
- bit 3 (8) — a mídia entrou em modo somente leitura
- bit 4 (16) — o sistema de backup da memória volátil falhou
temperature
Temperatura atual do dispositivo (pode estar em Kelvin). O superaquecimento constante do SSD leva a uma falha rápida, então este parâmetro precisa ser monitorado.
percentage_used
Porcentagem da vida útil do SSD já consumida. Quando este parâmetro chega a 100%, o ciclo de vida do SSD terminou e o disco entra em modo somente leitura (bloqueado). É um parâmetro muito importante. A tarefa do administrador é acompanhar os discos com antecedência e trocar os SSDs que estão com pouca vida útil restante.
media_errors
Número de vezes em que o controlador encontrou um erro fatal de integridade dos dados. Se o valor cresce o tempo todo, considere trocar o SSD.
num_err_log_entries
Número de entradas no log de erros ao longo da vida do controlador. Como no caso anterior, acompanhe o crescimento deste parâmetro.
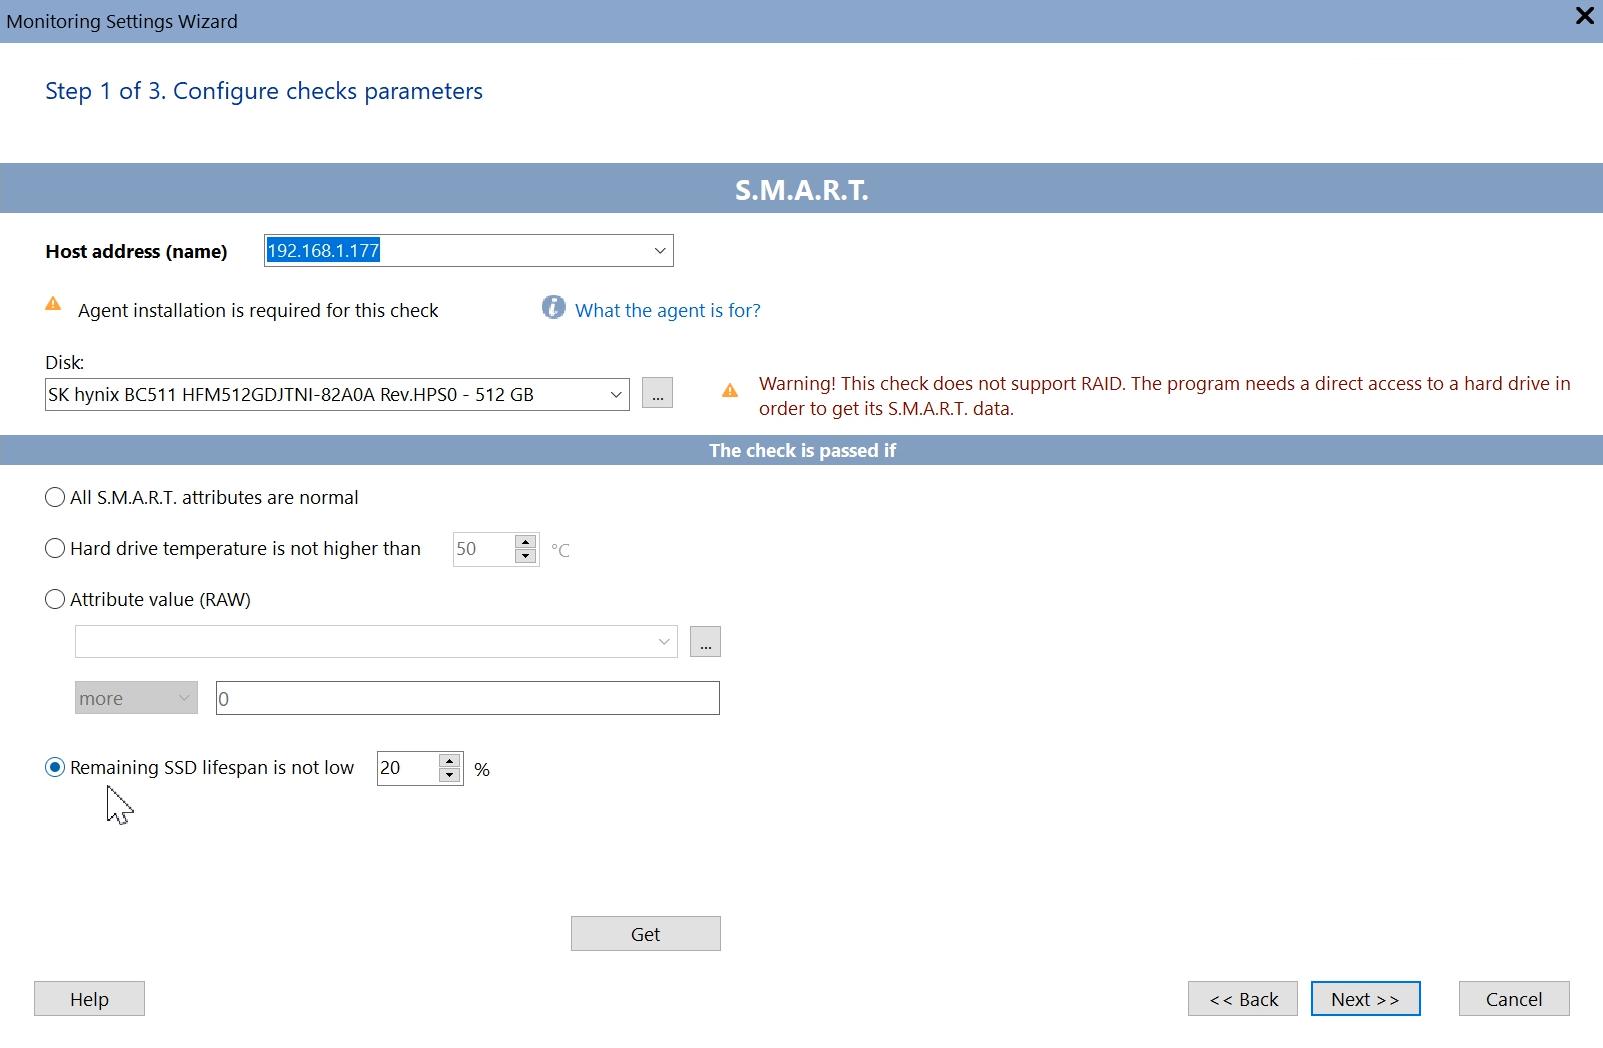
Com o 10-Strike Network Monitor Pro, é simples acompanhar o parâmetro percentage_used, que corresponde à vida útil do SSD NVMe, e também os demais parâmetros.
Monitoramento de SSD SATA e principais atributos de saúde
A saúde de SSDs anteriores ao NVMe também pode ser monitorada. Esses discos exibem indicadores como "the total number of LBA sectors written" (Total LBA Written). O contador mostra quantos setores de 512 bytes foram gravados ao longo de toda a vida do disco. As opções possíveis são:
241 - Total LBA Written — total de setores de 512 bytes gravados durante toda a vida do dispositivo.
ou
175 - Host_Writes_MiB — quantos MiB (milhões de bytes) foram gravados no disco.
O limite de volume de gravação ao longo da vida útil de endurance está na documentação do SSD, no site do fabricante ou no manual. Em geral é medido em terabytes (TB) ou terabytes gravados (TB Written ou TBW). Valores típicos dos discos atuais vão de 40 TB (modelos de 5 a 10 anos) a várias centenas de TB (discos modernos).
Você monitora todos esses parâmetros e atributos SMART de SSD com o nosso programa (e as instruções acima), define limites críticos e recebe aviso quando os valores saem da faixa. Também dá para ver os volumes gravados, em porcentagem do máximo permitido, em indicadores retangulares (barras de progresso).
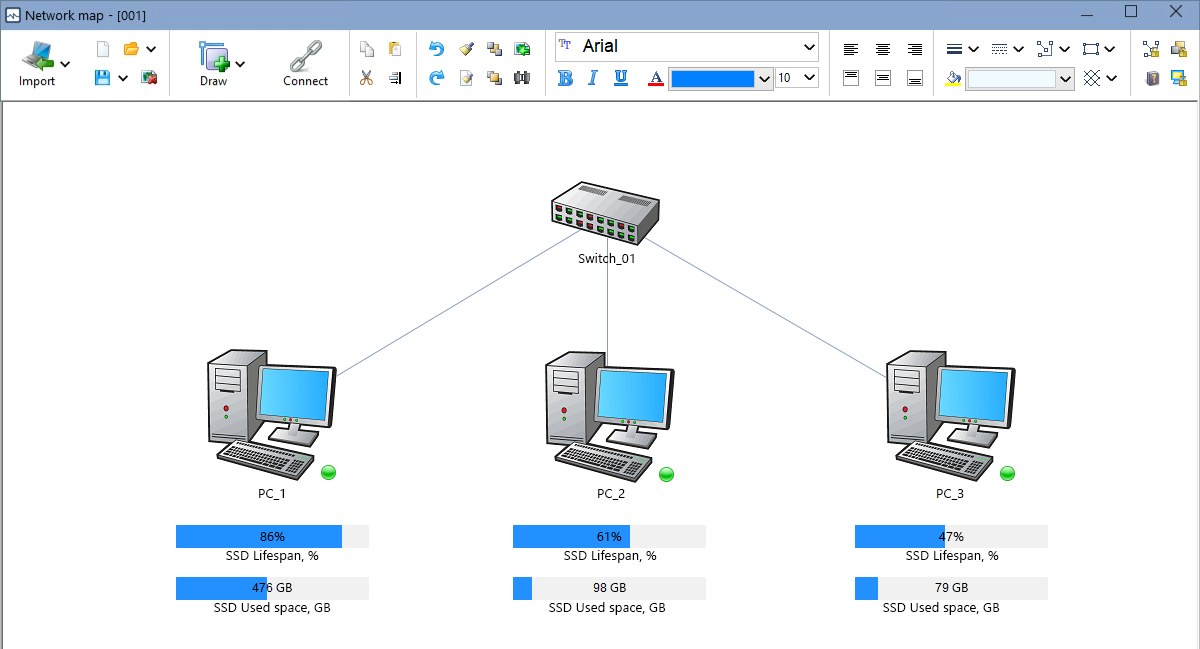
Você também acompanha outros atributos, como o crescimento de erros. O conjunto de parâmetros recebidos do disco aparece na janela de configuração da verificação SMART.
É simples configurar o monitoramento de TBW do SSD com o 10-Strike Network Monitor Pro.
Widgets com os resultados do monitoramento de SSD no mapa gráfico
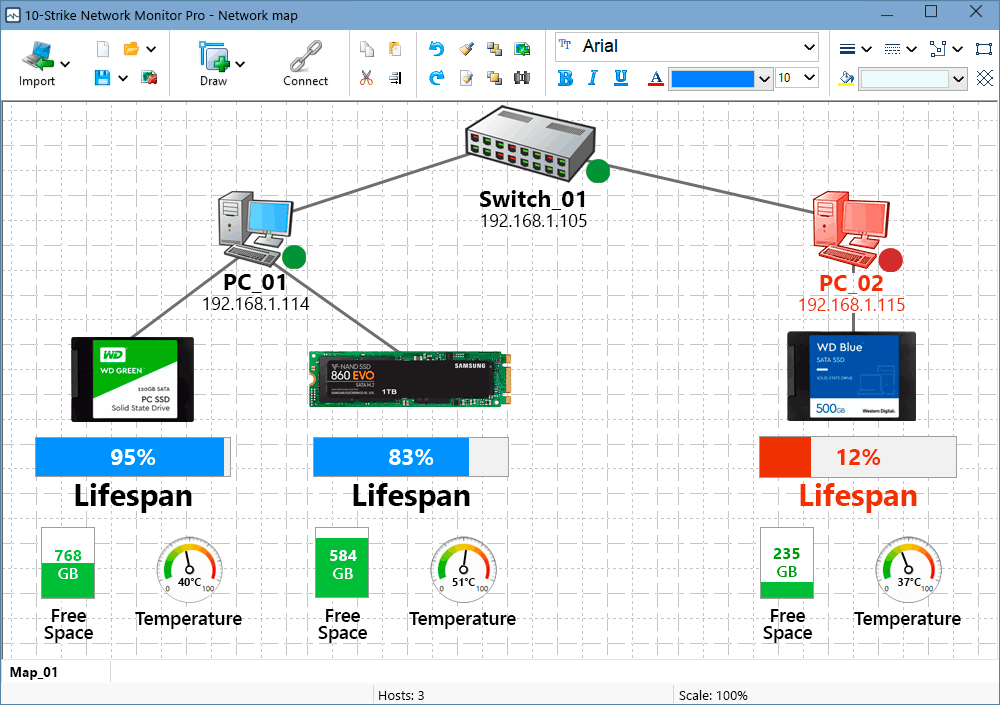
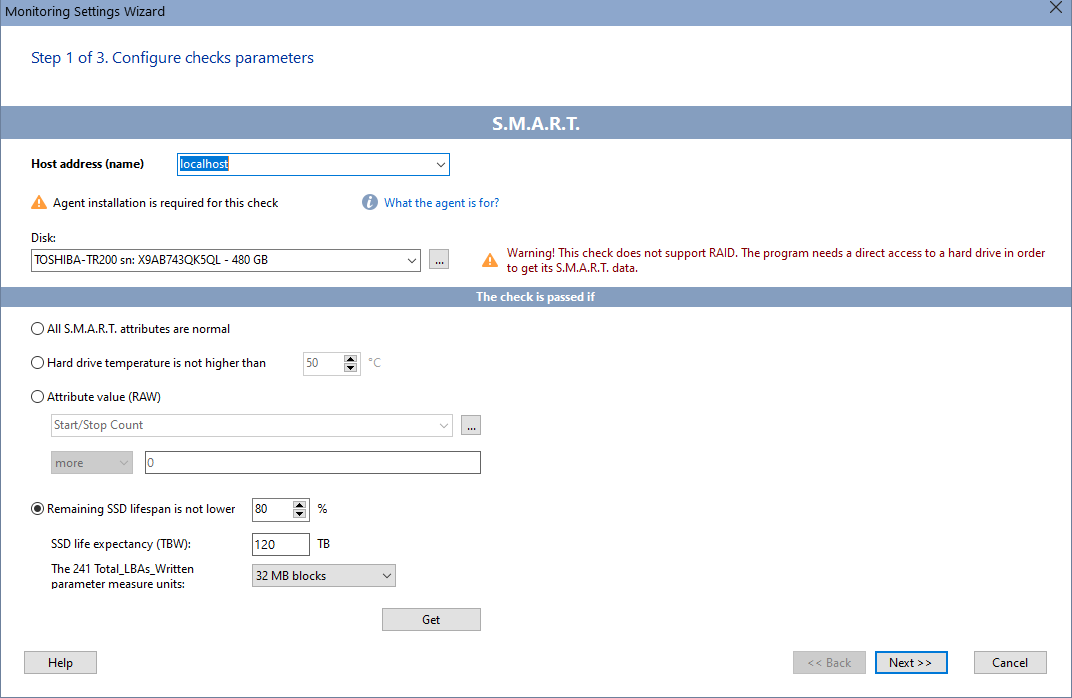
Você também acompanha os resultados do SSD no mapa gráfico, com widgets e indicadores (barras e medidores). Dá para exibir a vida útil restante ou consumida, a temperatura, o espaço livre em disco e outros valores.
Vídeo
Gravamos um vídeo curto que explica o monitoramento SMART de SSD. Você pode assistir.
Conclusão
Monitorar atributos S.M.A.R.T. não resolve tudo. A tecnologia serve para você perceber a tempo a piora dos parâmetros críticos do disco e trocar a mídia antes da perda de dados. Se você faz backup com regularidade e acompanha os atributos S.M.A.R.T. dos discos rígidos (ou do SSD), reduz o risco de perda e evita o custo alto de recuperação. Vale a regra: atributos S.M.A.R.T. bons não garantem que o disco está saudável, mas atributos ruins quase sempre denunciam um problema.
Para testar o comportamento no seu ambiente, baixe e experimente a versão de avaliação gratuita de 30 dias, com todos os recursos.
Nossos clientes
 10-Strike Network Monitor Pro na resenha anual de software da PC Magazine/RE, "Best Soft 2015":
"Este programa monitora a infraestrutura de TI, de switches e servidores até UPS e sensores de porta em racks com equipamentos consultados por SNMP. Dá para controlar não só se o dispositivo funciona, mas também se algum parâmetro ultrapassa limites críticos. Por exemplo, a temperatura da CPU, a tensão, o nível de toner de uma impressora, o nível de sinal em uma fibra óptica ou o espaço livre nos discos. Há vários meios de notificação para o administrador. Os gráficos dos parâmetros ajudam a prever tendências antes de uma falha real."