 Hoy, perder datos importantes puede ser más grave que perder un activo tangible. En algunos casos, un negocio puede colapsar por la pérdida de datos vitales. Ese problema suele deberse a una falla súbita del medio de almacenamiento, aunque no siempre es instantánea. Los discos duros suelen fallar por degradación lenta de piezas mecánicas y platos magnéticos. Como una persona, un disco puede «sentirse mal» mucho tiempo antes de fallar. Los administradores deben vigilar señales de falla inminente para reemplazarlo a tiempo, tras copiar los datos valiosos a medios sanos.
Navegación del artículo
- Métodos de diagnóstico del estado y la salud del disco
- Cómo configurar el monitoreo de salud y estado de HDD/SSD
- Monitoreo SMART de HDD y atributos importantes
- Monitoreo de SSD NVMe y atributos principales de salud
- Monitoreo de SSD SATA y atributos principales de salud
- Mostrar widgets con resultados de monitoreo SSD en el mapa gráfico
- Reseña en video
- Conclusión
Métodos de diagnóstico del estado y la salud del disco
Afortunadamente, los discos duros pueden autodiagnosticarse mediante S.M.A.R.T. (Self-Monitoring, Analysis, and Reporting Technology). Los primeros estándares se desarrollaron en 1995 entre grandes fabricantes. Desde entonces la tecnología S.M.A.R.T. mejoró mucho. Cada fabricante define un conjunto de «S.M.A.R.T. Attributes» que considera importantes; monitorearlos mejora la confiabilidad del sistema. Al encenderse, el disco verifica y actualiza sus atributos S.M.A.R.T.; los valores se guardan en un área accesible solo por el firmware. Cada fabricante también fija umbrales que no deberían superarse en condiciones normales.
Entre otras tareas, cada administrador debe revisar con regularidad atributos SMART críticos y asegurarse de que permanezcan en límites seguros. Hay aplicaciones que leen SMART y los muestran de forma clara. Pero con la rutina diaria es fácil olvidar la revisión y perder el inicio de una situación crítica, como:
- temperatura crítica
- aumento exponencial de errores de lectura/escritura
- errores de búsqueda (seek)
- sectores reasignados
Por eso recomendamos un sistema de monitoreo que verifique atributos SMART automáticamente 24/7 y le notifique de inmediato cualquier situación anormal.
Los discos SSD (y SSD NVMe) ofrecen un conjunto distinto de parámetros. A diferencia del HDD, un SSD no reasigna sectores ni tiene problemas de superficie. El parámetro principal es el estado de vida útil: el número total de operaciones de escritura está limitado. Debe revisar el uso del SSD y controlar que el porcentaje de vida consumida esté bajo el umbral permitido.
Puede monitorear en SSD los siguientes parámetros de salud:
- spare disponible
- percentage used (porcentaje usado)
- Temperatur
- lecturas/escrituras
- contadores de errores
- advertencia crítica (modo solo lectura, etc.)
Cómo configurar el monitoreo de salud y estado de HDD/SSD
10-Strike Network Monitor Pro es un producto versátil que puede monitorear muchas cosas, incluidos atributos SMART de HDD, SSD y NVMe. Instálelo en uno de sus servidores y sus agents en las computadoras cuyos discos desee monitorear. Network Monitor escaneará la red, encontrará hosts y los agregará a la lista. Cree la comprobación «S.M.A.R.T.» en hosts con Agent; se ejecutará a intervalos regulares (desde segundos hasta horas). El núcleo analizará valores de cada Agent, los comparará con umbrales y, si se superan, puede notificarle por SMS, correo, etc.
Es sencillo crear una comprobación «S.M.A.R.T.» para monitorear atributos de salud del disco. Debe hacer lo siguiente:
• Instale 10-Strike Network Monitor Pro.
• Instale el Agent de Network Monitor en cada host cuyo disco desee monitorear. El Agent es un servicio de Windows que lee atributos S.M.A.R.T. y los envía al núcleo de monitoreo.
• Inicie Network Monitor y ejecute un escaneo de red, o agregue los hosts manualmente.
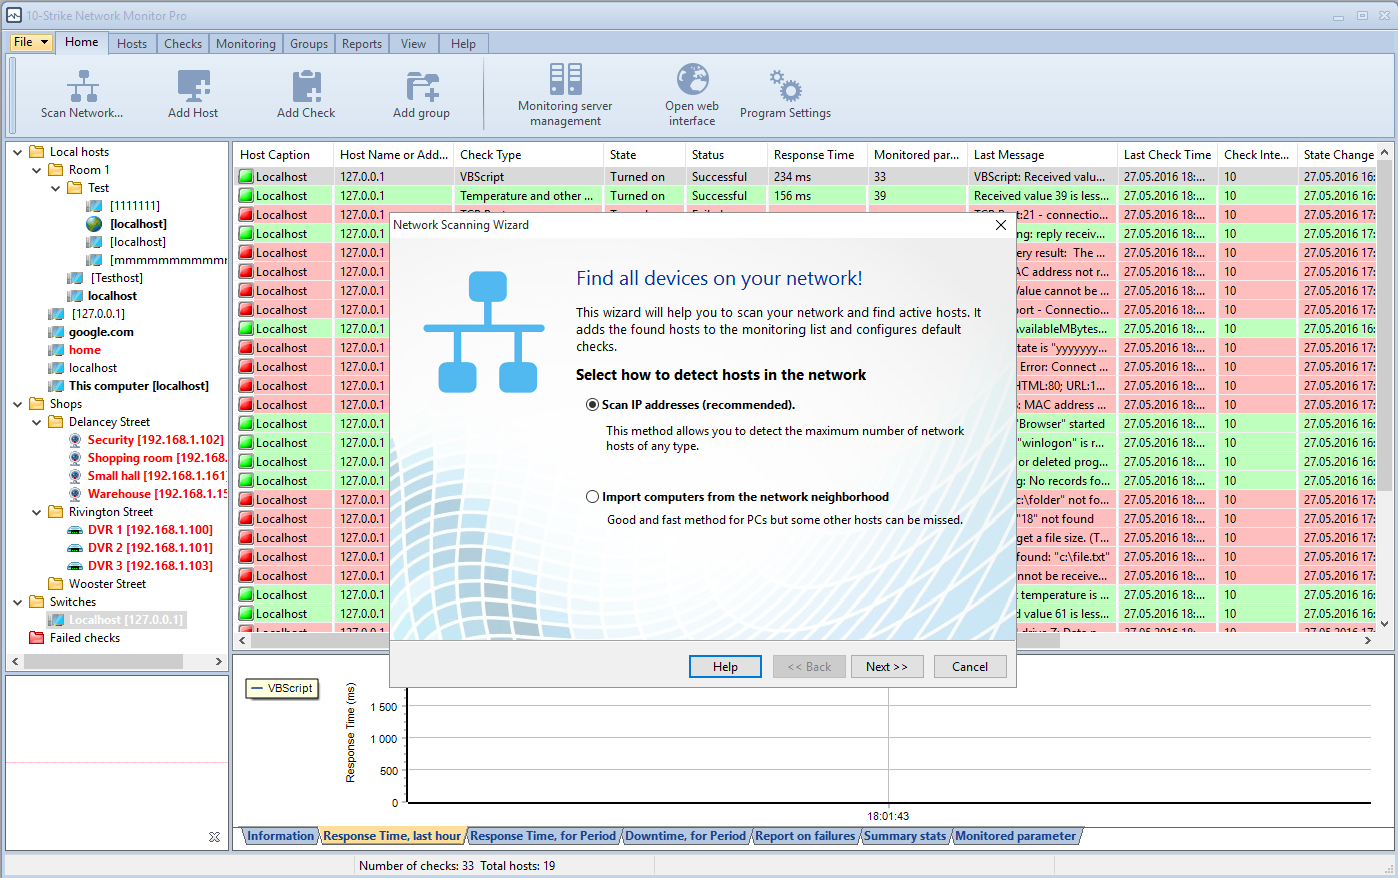
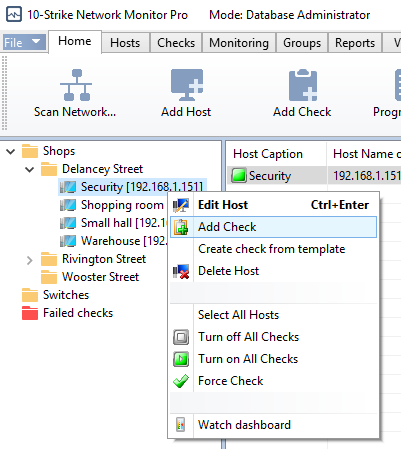
• Seleccione el host en el árbol (a la izquierda) y elija «Add check» en su menú contextual.
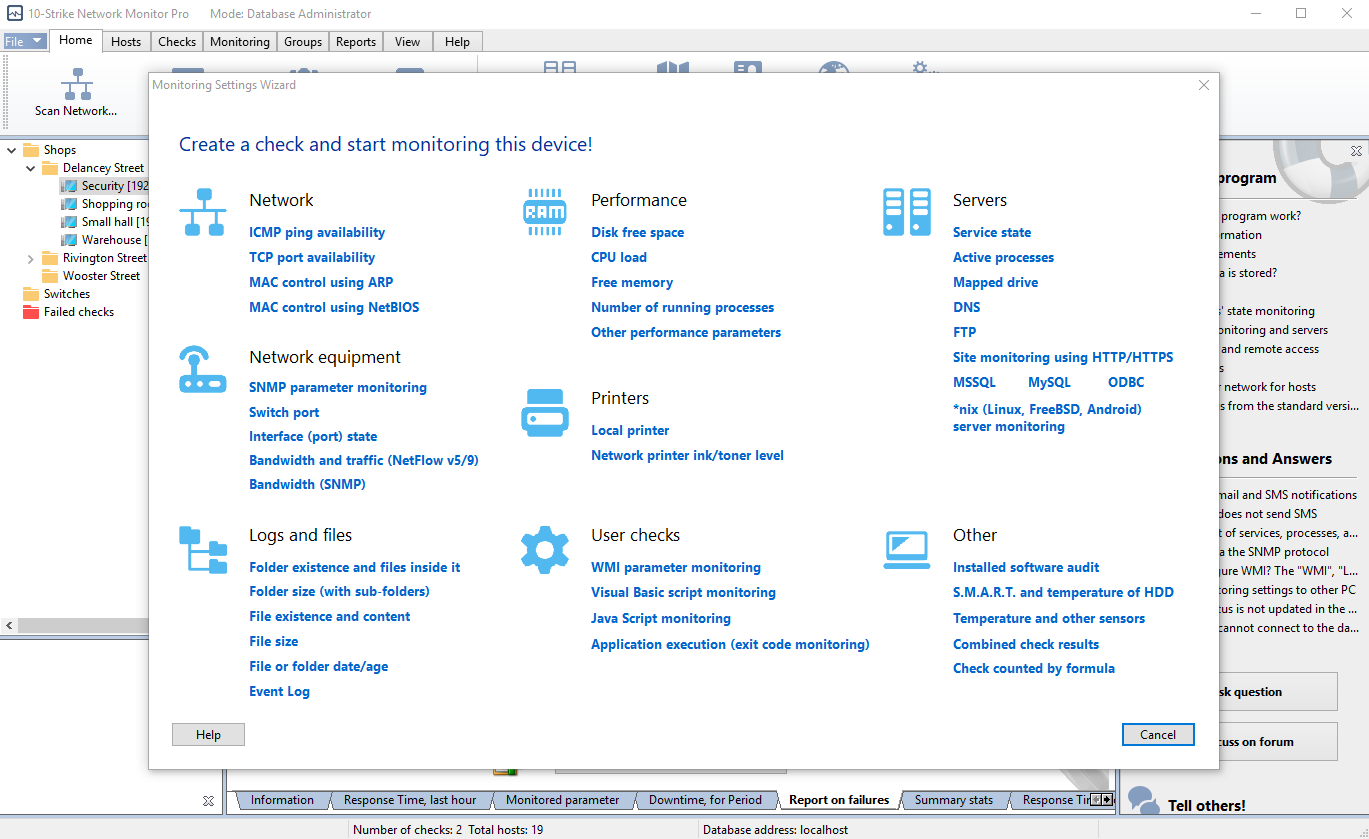
• En el cuadro «Check parameters», seleccione el tipo de comprobación («S.M.A.R.T.»). Luego haga clic en el botón «…» a la derecha de «Hard drive» y elija un HDD o SSD.
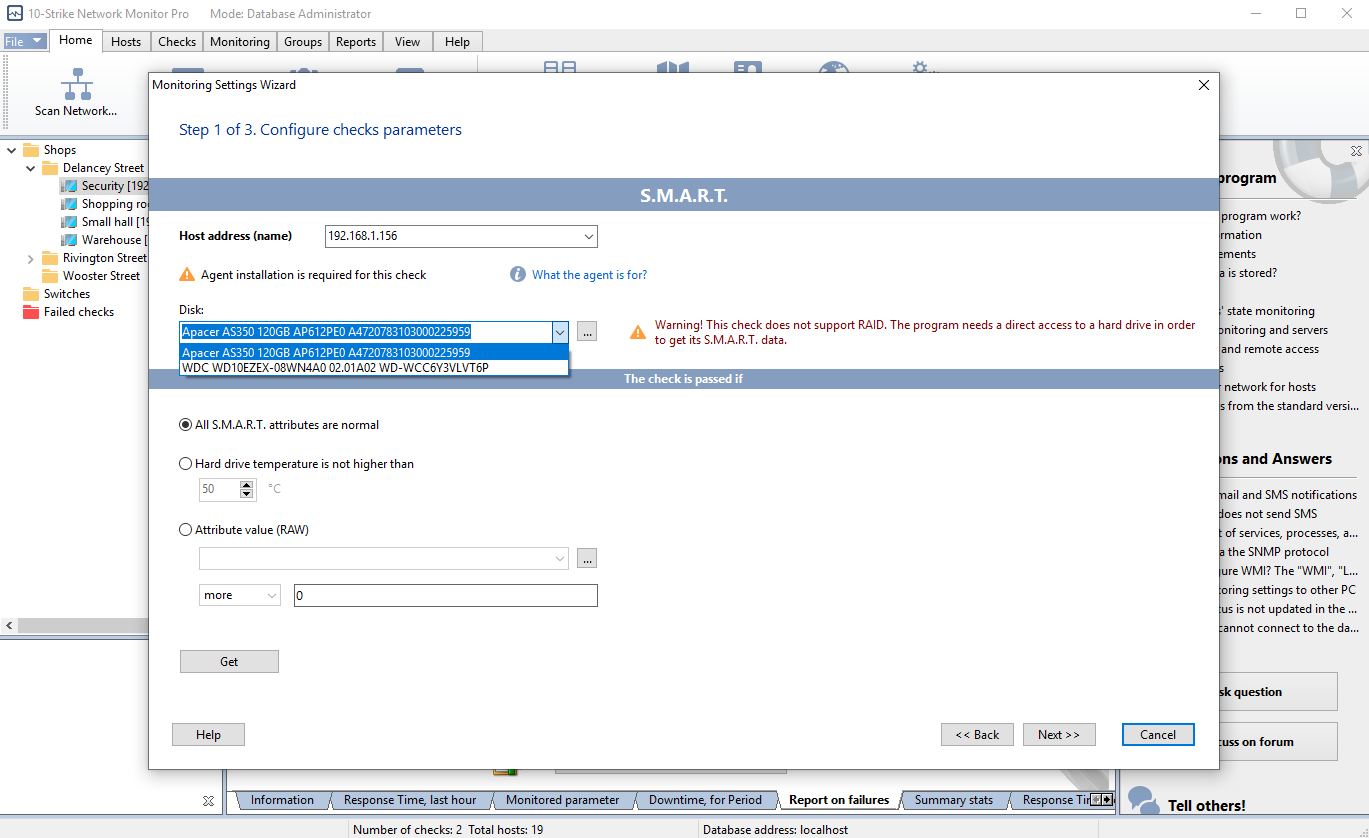
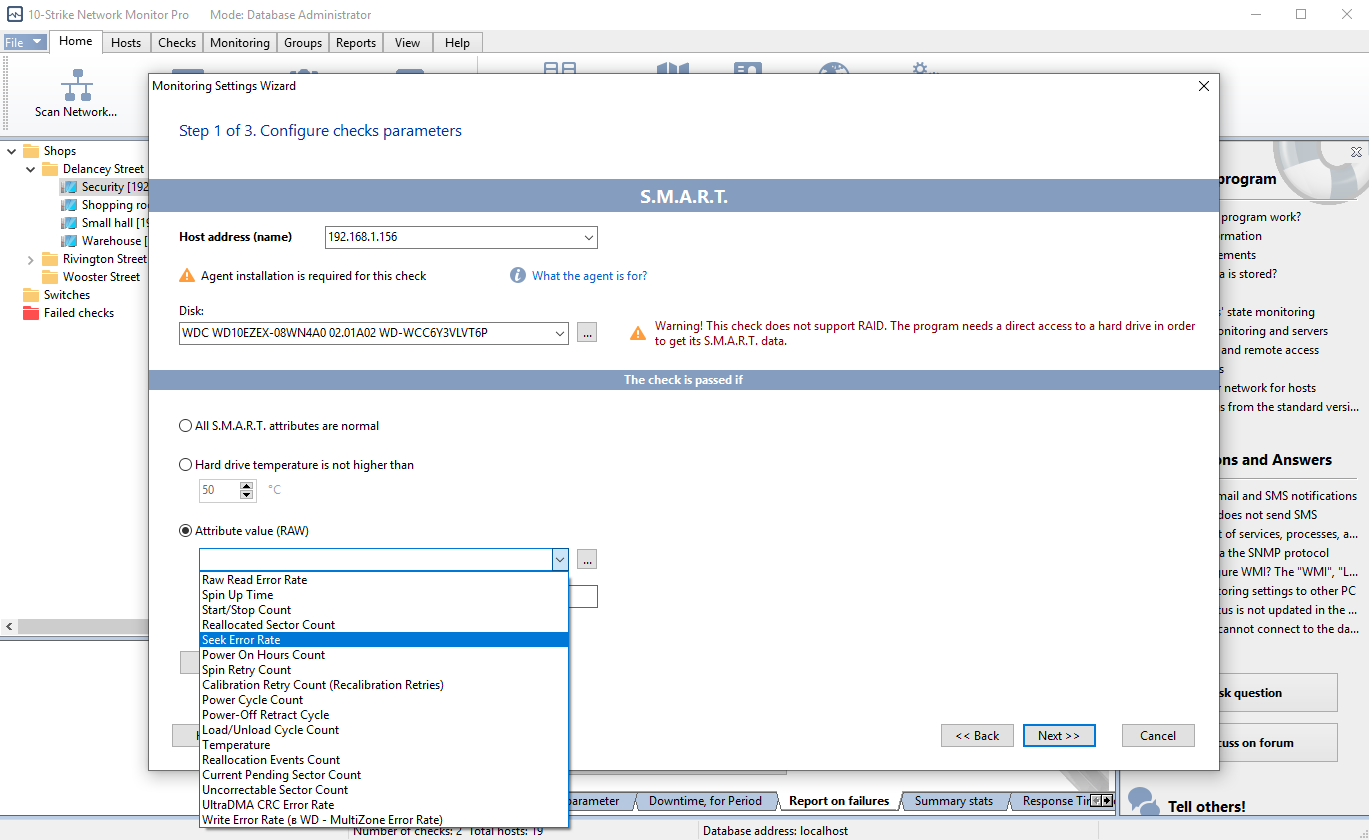
• Seleccione el atributo S.M.A.R.T. a monitorear (por ejemplo, «Temperature» o «Seek Error Rate»). Haga clic en «…» a la derecha de «Attribute value (RAW)» y elija el nombre en la lista.
• Defina las condiciones de alarma (por ejemplo: «La comprobación es exitosa si el valor del atributo es menor que 50»).
• Configure los parámetros de inicio de la comprobación o deje los predeterminados. Defina las notificaciones y guarde los cambios.
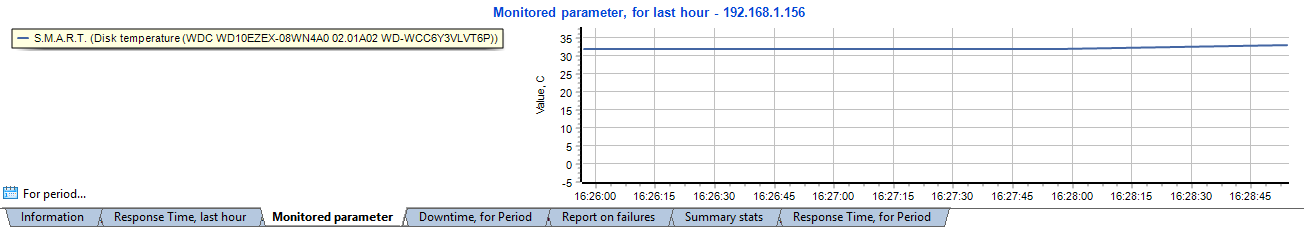
Al agregar la comprobación, comenzará a recopilar datos. Siga el proceso en la pestaña «Monitored parameter» (parte inferior de la ventana). Network Monitor mostrará un gráfico del atributo S.M.A.R.T. seleccionado.
Monitoreo SMART de HDD y atributos importantes
A continuación, una lista de los atributos S.M.A.R.T. más importantes en HDD. La selección depende del medio: un SSD no ofrece el mismo conjunto que un disco duro.
· #01 Raw Read Error Rate — Tasa de errores de lectura de hardware al leer datos del plato magnético.
· #03 Spin-Up Time — Tiempo medio de arranque del husillo. Un aumento indica desgaste mecánico (fricción en el rodamiento) o alimentación insuficiente (caídas de voltaje al arrancar).
· #05 Reallocated Sectors Count — Número de sectores defectuosos reasignados automáticamente por el firmware. Ante un error de lectura/escritura, el firmware marca el sector y transfiere datos al área reservada. El valor raw es el total de sectores reasignados; cuanto mayor, peor el estado de la superficie.
· #07 Seek Error Rate — Tasa de errores de búsqueda de los cabezales. Un aumento indica mala superficie del plato o falla parcial del posicionamiento mecánico; también puede deberse a sobrecalentamiento o vibración externa.
· #10 Spin-Up Retry Count — Número de reintentos de arranque del husillo; un aumento indica problemas en el subsistema mecánico del disco.
· #196 Reallocation Event Count — Número de operaciones de reasignación; intentos de transferir datos de sectores defectuosos al área reservada (suele ser pequeña). Se cuentan intentos exitosos y fallidos.
· #197 Current Pending Sector Count — Número de sectores «inestables» pendientes de reasignación por errores de lectura irrecuperables; aún no marcados como malos, pero la lectura es poco fiable. Si luego se lee con éxito, se marca como bueno; si no, el firmware intentará reasignarlo.
· #198 Uncorrectable Sector Count — Total de sectores ilegibles o no escribibles; un aumento indica defectos graves de superficie o del subsistema mecánico.
· #220 Disk Shift — Desplazamiento de los platos respecto al husillo, normalmente por golpe mecánico; un aumento grande indica disco inutilizable.
Monitoreo de SSD NVMe y atributos principales de salud
El conjunto de parámetros S.M.A.R.T. de SSD NVMe difiere del de unidades ATA: suele ser un conjunto de indicadores listos, sin umbrales ni peores valores. Ejemplo para WD Blue SN500 M.2 SSD:
critical_warning: 0
temperature: 39
available_spare: 100
available_spare_threshold: 10
percentage_used: 1
data_units_read: 13733602
data_units_written: 14396473
host_reads: 365745477
host_writes: 391133456
controller_busy_time: 836
power_cycles: 1419
power_on_hours: 4612
unsafe_shutdowns: 13
media_errors: 0
num_err_log_entries: 1
warning_temp_time: 0
critical_comp_time: 0
Entre estos parámetros, los más interesantes son:
critical_warning
Parámetro que indica el estado del disco:
- valor 0 — disco en orden
- bit 0 (1) — available spare por debajo del umbral
- bit 1 (2) — temperatura superó el umbral
- bit 2 (4) — fiabilidad degradada por errores excesivos del medio o internos
- bit 3 (8) — medio en modo Read-Only
- bit 4 (16) — falló el sistema de respaldo de memoria volátil
temperature
Temperatura actual del dispositivo (puede estar en Kelvin). El sobrecalentamiento constante acorta la vida del SSD; conviene monitorear este parámetro.
percentage_used
Porcentaje de vida útil del SSD consumida. Cuando este parámetro llegue al 100%, el ciclo de vida del SSD habrá terminado y el disco pasará a modo solo lectura (bloqueado). Es un parámetro muy importante. El administrador debe detectar discos con poco recurso restante y reemplazarlos a tiempo.
media_errors
Número de veces que el controlador encontró un error fatal de integridad de datos. Si crece constantemente, considere reemplazar el SSD.
num_err_log_entries
Número de entradas de registro de errores durante la vida del controlador; preste atención a su crecimiento.
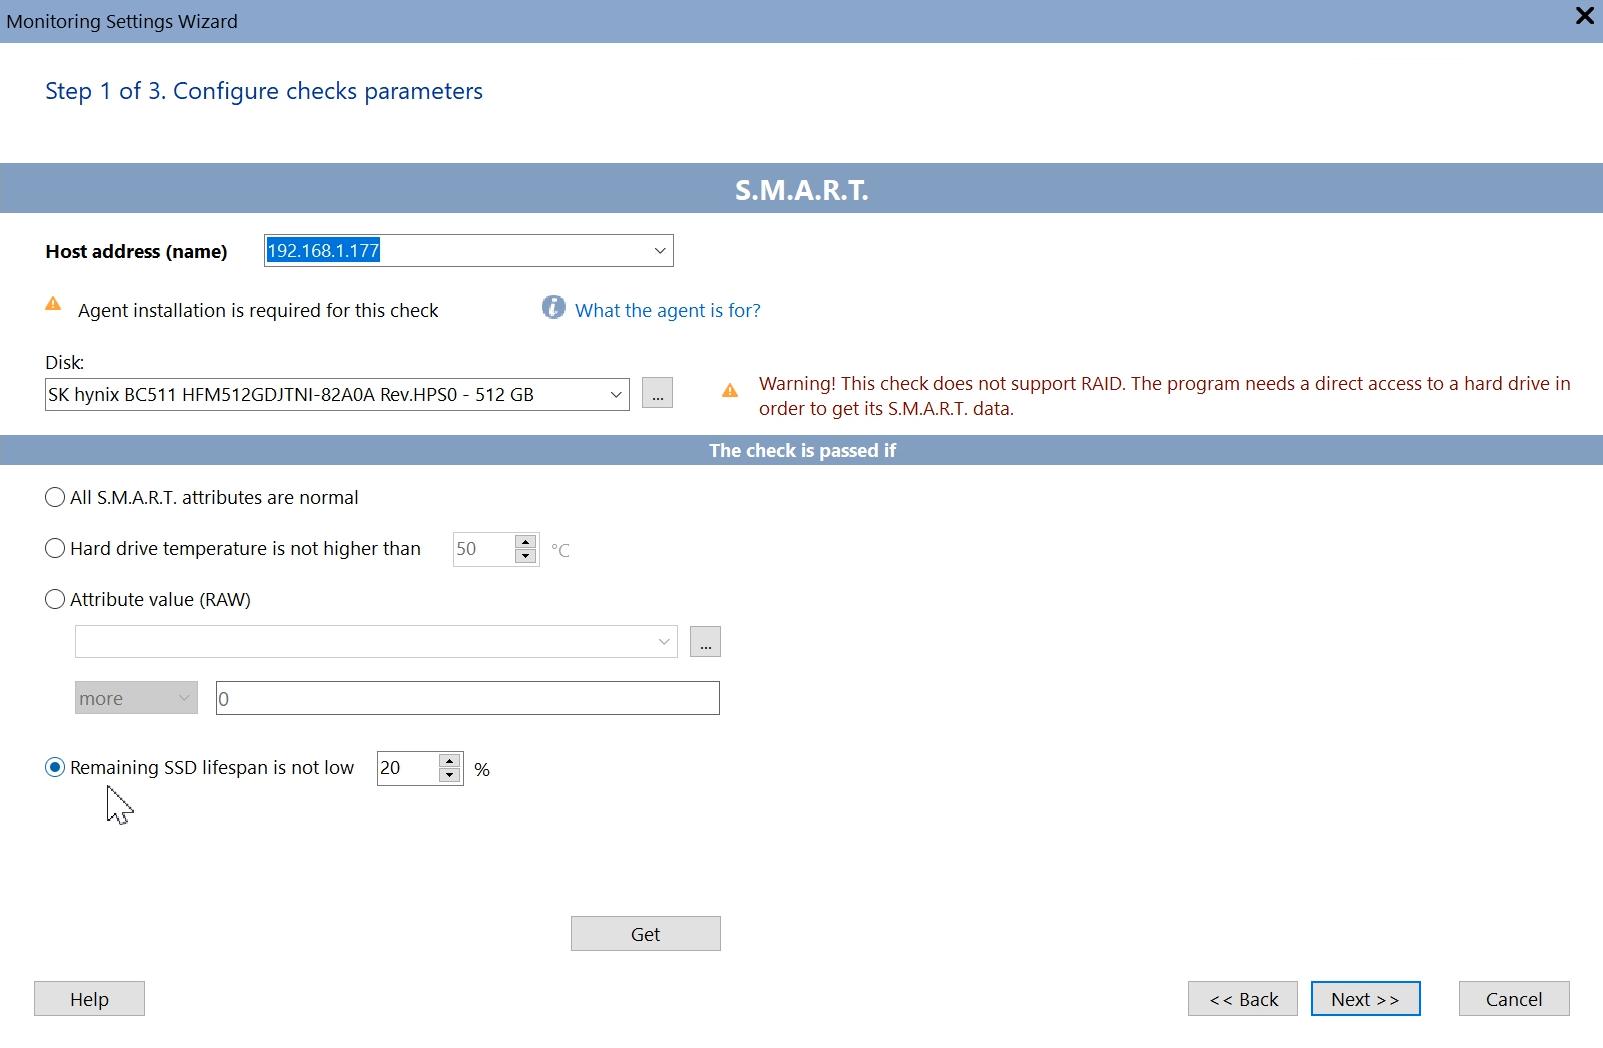
Puede monitorear fácilmente el parámetro percentage_used (vida útil NVMe) y otros parámetros con 10-Strike Network Monitor Pro.
Monitoreo de SSD SATA y atributos principales de salud
También puede monitorear SSD anteriores a NVMe. Pueden mostrar indicadores como «total de sectores LBA escritos» (Total LBA Written): cuántos sectores de 512 bytes se escribieron en toda la vida del disco. Opciones posibles:
241 – Total LBA Written – total de sectores de 512 bytes escritos en toda la vida del dispositivo.
o
175 – Host_Writes_MiB – cuántos MiB (millones de bytes) se escribieron en el disco.
El umbral de volumen de escritura durante la vida útil de resistencia (endurance) está en la documentación del fabricante. Suele medirse en terabytes (TB Written o TBW). Valores típicos: de 40 TB (modelos de 5–10 años) a varios cientos de TB en discos monos.
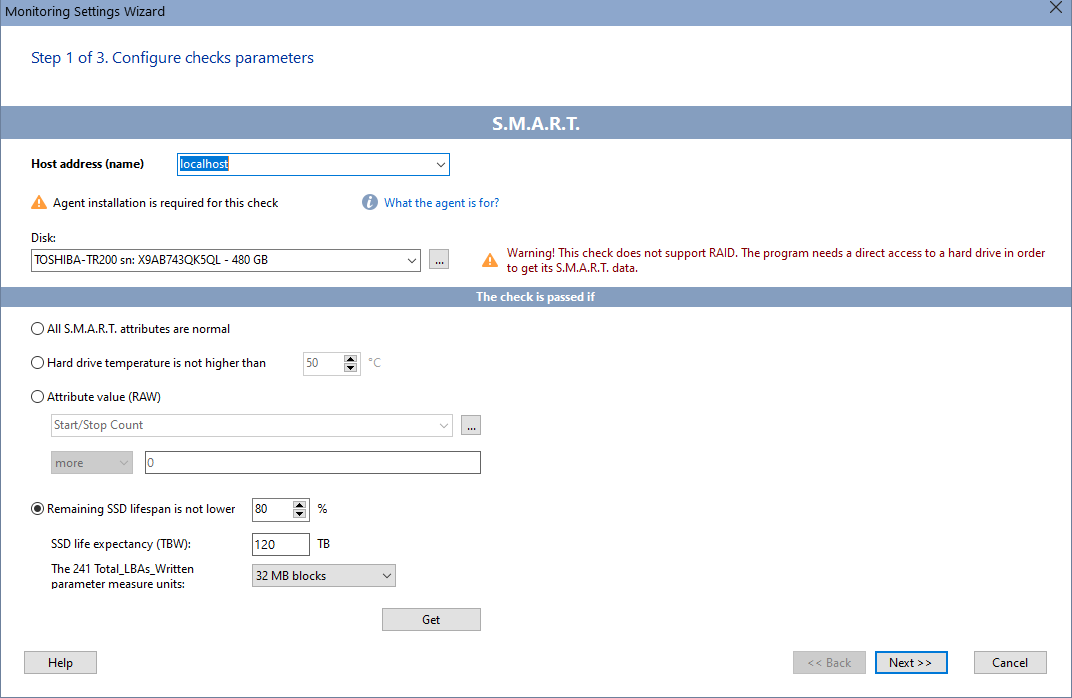
Puede monitorear todos estos parámetros SMART con nuestro programa (véase la instrucción anterior), fijar umbrales críticos y recibir alertas cuando se superen. También puede ver volúmenes escritos como porcentaje del máximo permitido en barras de progreso.
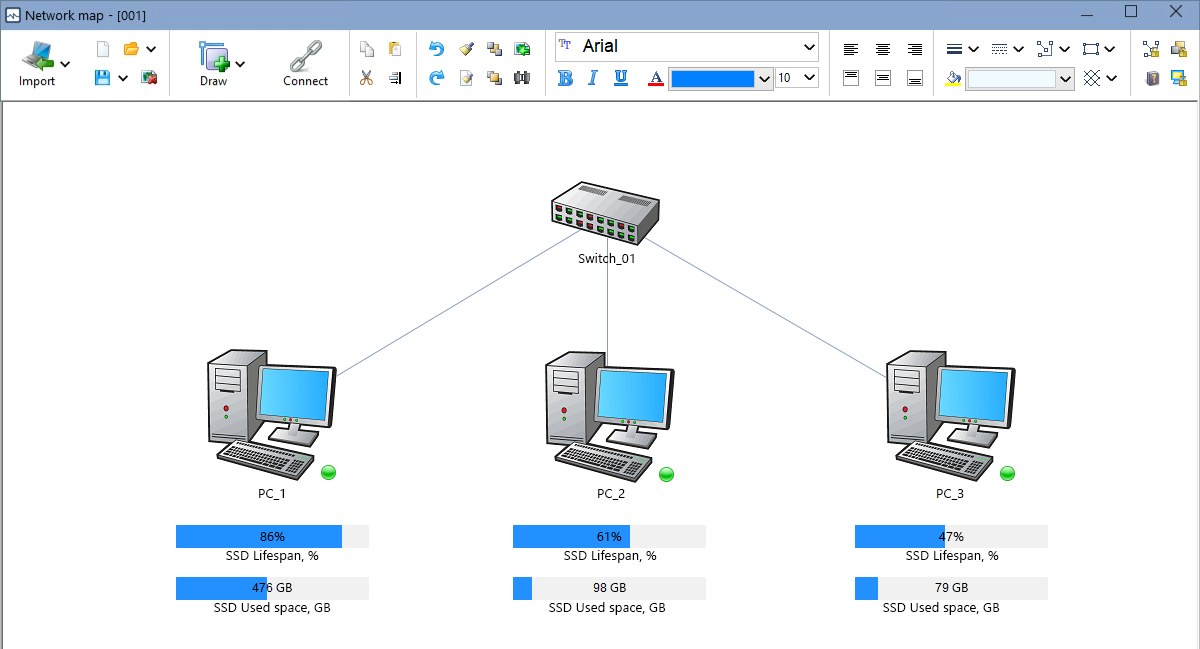
También puede revisar otros atributos, como el crecimiento de errores. Verá el conjunto de parámetros del disco en la ventana de configuración de la comprobación SMART.
Puede configurar fácilmente el monitoreo TBW de SSD con 10-Strike Network Monitor Pro.
Mostrar widgets con resultados de monitoreo SSD en el mapa gráfico
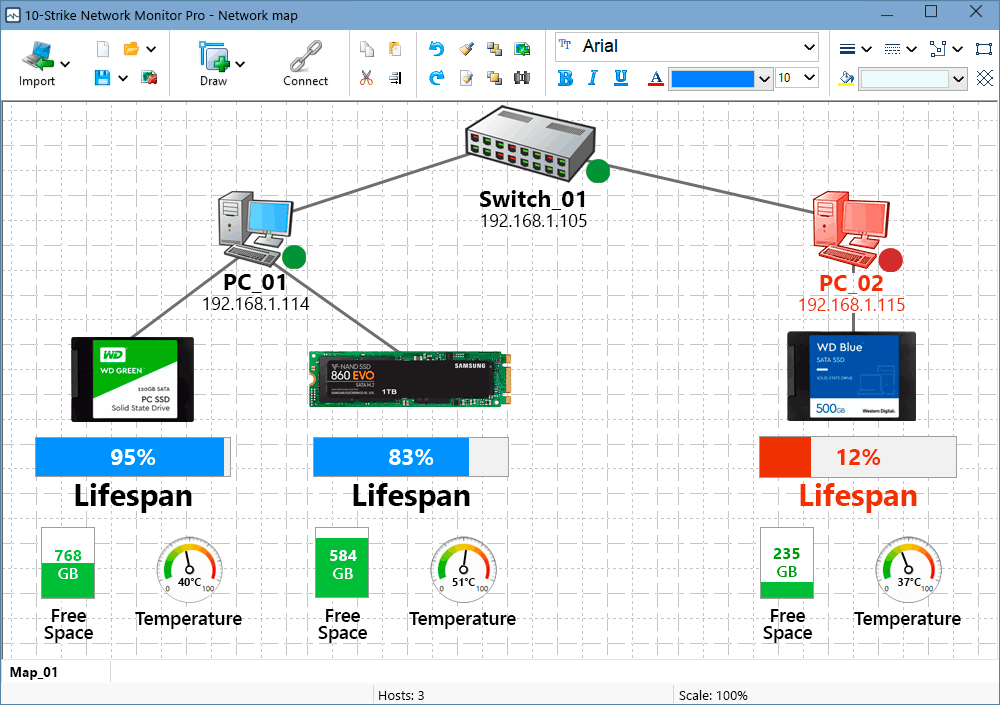
También puede ver resultados de monitoreo SSD en un mapa gráfico con widgets e indicadores (barras y medidores): vida útil restante o usada, temperatura, espacio libre, etc.
Reseña en video
Hemos creado un video breve que explica el concepto de monitoreo SMART de SSD. También puede verlo.
Conclusión
El monitoreo de atributos S.M.A.R.T. no es una panacea. La tecnología ayuda a detectar a tiempo el deterioro de parámetros críticos y reemplazar el medio antes de perder datos. Si respalda con regularidad y monitorea atributos SMART de HDD/SSD, reduce riesgos y costos de recuperación. Recuerde: atributos SMART buenos no garantizan un disco sano, pero los malos suelen ser señal clara de problema.
Para probar el rendimiento en su entorno, le recomendamos descargar y probar nuestra versión de prueba gratuita de 30 días con todas las funciones.
Nuestros clientes
 10-Strike Network Monitor Pro en la reseña anual de software de PC Magazine/RE «Best Soft 2015»:
„Este programa permite monitorear la infraestructura de TI desde switches y servidores hasta UPS y sensores de puerta en racks con equipos consultados mediante SNMP. Permite controlar no solo el funcionamiento de los dispositivos, sino también comprobar si parámetros superan umbrales críticos: temperatura de CPU, voltaje, nivel de tóner, señal en fibra óptica o espacio libre en discos. Hay varios métodos de notificación para el administrador. Los diagramas de parámetros ayudan a prever tendencias antes de una falla real.“