
Esta función solo está disponible en la versión PRO. Se admiten unidades HDD, SSD, SATA y NVMe.
S.M.A.R.T. es un sistema de autodiagnóstico integrado del disco duro que mide y reporta diversos parámetros. También puede predecir cuándo fallará el disco duro. S.M.A.R.T. puede monitorear la temperatura del HDD y otros indicadores, incluidos algunos atributos que señalan un fallo inminente. Cabe señalar que S.M.A.R.T. puede predecir fallos mecánicos, que representan alrededor del 60 por ciento de todos los fallos de HDD.
La aplicación estima automáticamente los parámetros de fiabilidad especificados comparándolos con valores umbral y le advierte si un fallo del disco duro es inminente. Además, la aplicación puede estimar el estado general de un disco duro a partir de un conjunto de parámetros. Para que esta comprobación funcione, debe instalar el Remote Agent en el equipo de destino. Obtenga más información sobre los Remote Agents en la sección Instalación y configuración del Remote Agent.
Agregar la comprobación SMART y seleccionar un HDD o SSD para monitorear
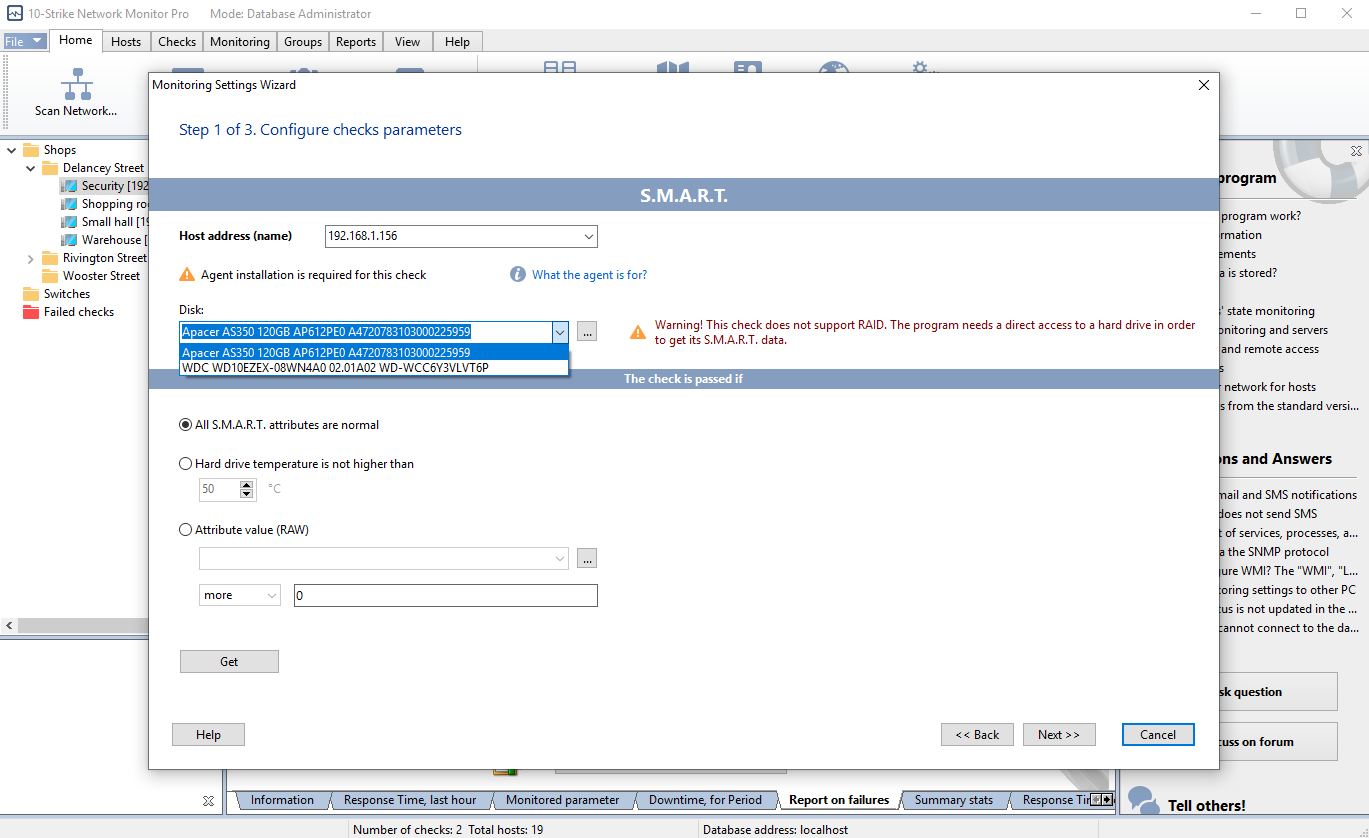
Configurar la comprobación SMART y seleccionar parámetros para monitorear
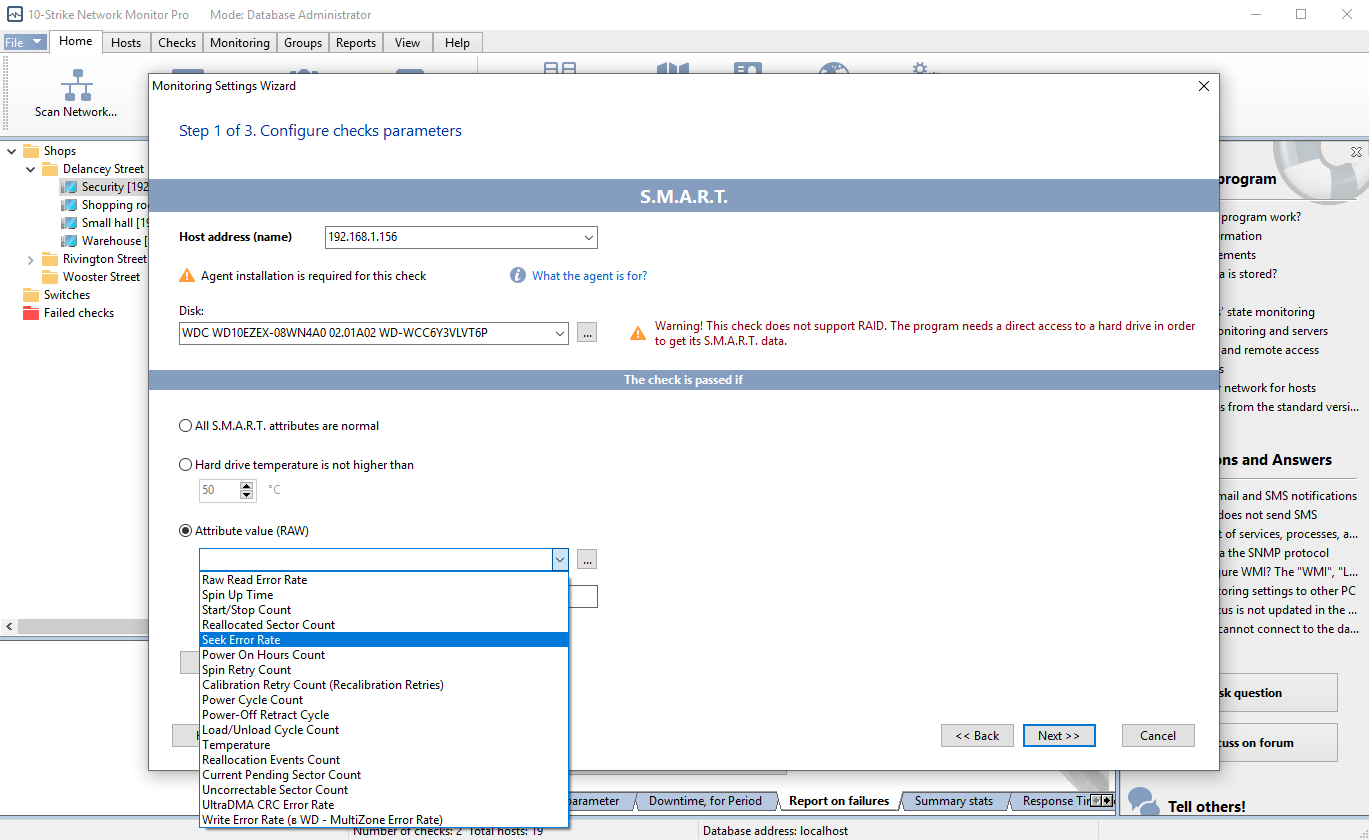
Puede mostrar el valor del parámetro seleccionado en un widget que se agregará al dashboard o se colocará en el mapa de red gráfico.
Resolver el problema de recepción de datos SMART
Si el programa no recibe los datos S.M.A.R.T. de uno de sus discos, o no aparece en la lista, intente cambiar el Agent a otro modo. Con este modo, el Agent intentará recibir los datos S.M.A.R.T. mediante la utilidad smartmontools. Para habilitar esta función, abra el archivo de configuración del Agent NMAgent.ini con cualquier editor de texto y agregue la línea:
GetSMARTMode=1
Ejemplo:
[AGENT]
TCPPort=45668
UsePasswd=0
Passwd=
UseIPFilter=0
IPList=
GetSMARTMode=1
Guarde el archivo y reinicie el 10-Strike Network Monitor Agent Service.
El archivo NMAgent.ini puede estar en las siguientes carpetas:
- c:\Program Files (x86)\10-Strike Network Monitor Agent\ si el Agent se instaló sin el programa principal.
- c:\Program Files (x86)\10-Strike Network Monitor Pro\ si el Agent se instaló junto con el programa principal.
Monitoreo de parámetros S.M.A.R.T. para unidades SSD NVMe
El conjunto de parámetros S.M.A.R.T. para discos SSD NVMe es distinto al de los parámetros de discos duros ATA. En la mayoría de los casos, es un conjunto de indicadores listos, sin especificar umbrales ni valores de peor caso. Aquí un ejemplo de parámetros S.M.A.R.T. para el SSD M.2 WD Blue SN500:
critical_warning: 0
temperature: 39
available_spare: 100
available_spare_threshold: 10
percentage_used: 1
data_units_read: 13733602
data_units_written: 14396473
host_reads: 365745477
host_writes: 391133456
controller_busy_time: 836
power_cycles: 1419
power_on_hours: 4612
unsafe_shutdowns: 13
media_errors: 0
num_err_log_entries: 1
warning_temp_time: 0
critical_comp_time: 0
Entre estos parámetros, los más interesantes son:
critical_warning
El parámetro que indica el estado del disco:
- 0 — el disco está bien
- 1 — el recurso del disco está por debajo del umbral
- 2 — la temperatura superó el umbral
- 4 — la fiabilidad disminuye por errores internos
- 8 — el disco está en modo de solo lectura
- 16 — error del sistema de respaldo de memoria volátil
temperature
Temperatura en Celsius (a veces puede estar en Kelvin; conviene prestar atención). El sobrecalentamiento constante del SSD puede provocar su fallo rápido; por ello es necesario monitorear este parámetro.
percentage_used
Porcentaje del recurso del SSD consumido. En cuanto este parámetro llega a 100%, el SSD pasa a modo de lectura (bloqueado). Es un parámetro muy importante que requiere monitoreo. La tarea del administrador es detectar a tiempo aquellos discos cuyo recurso restante se acerca al valor máximo y reemplazarlos.
media_errors
El número de veces que el controlador encontró un error fatal de integridad de datos. Si el valor de este parámetro crece de forma constante, debería considerar reemplazar el SSD por uno nuevo.
num_err_log_entries
El número de entradas del registro de errores a lo largo de la vida del controlador. Como en el caso anterior, preste atención al crecimiento de este parámetro.
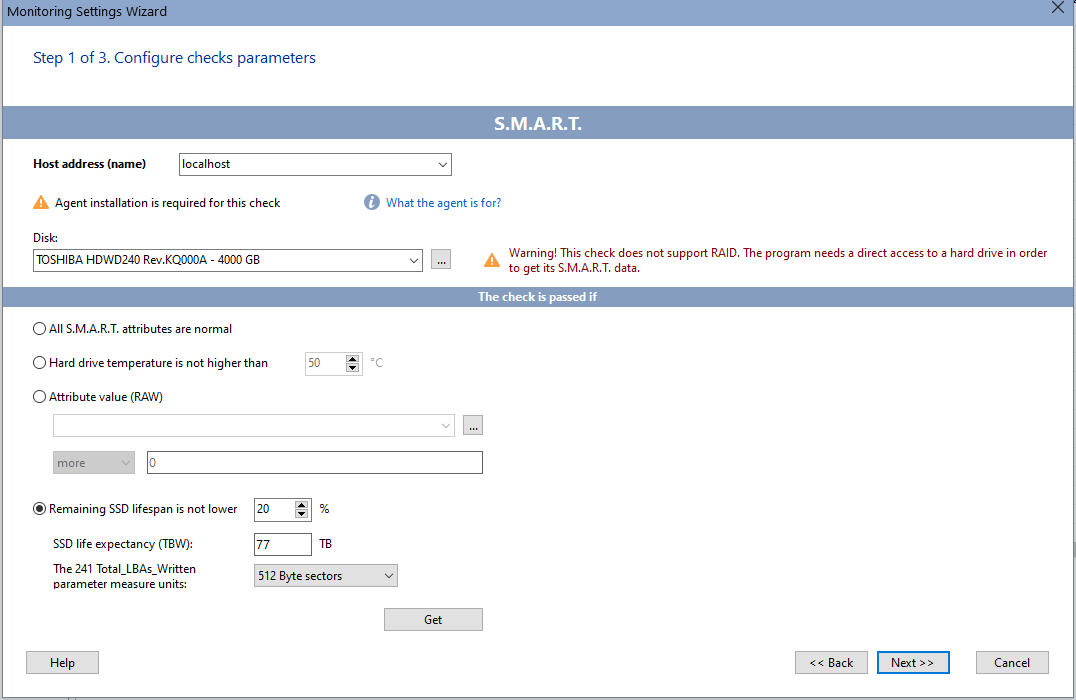
Monitoreo SMART de SSD SATA antiguos
También se puede monitorear la salud de SSD anteriores a NVMe. Tales discos pueden proporcionar valores métricos como "Total LBA Written Sectors" (Total LBA Written). Este contador muestra cuántos sectores de 512 bytes se escribieron en el disco a lo largo de toda su vida útil. Las opciones son:
241 - Total LBA Written (total de LBA escritos) — el número total de sectores de 512 bytes escritos durante toda la vida del dispositivo.
o
175 - Host_Writes_MiB — cuántos MB se escribieron en el disco.
Puede encontrar el valor umbral del volumen de escritura del disco a lo largo de su vida útil (o endurance) en la documentación del SSD en el sitio del fabricante o en las instrucciones. Suele medirse en terabytes (TB) o terabytes escritos (TB Written o TBW). Los valores típicos de las unidades modernas van de 40 (en modelos de hace 5-10 años) a varios cientos de TB (en unidades modernas). Al configurar la comprobación, debe indicar el límite máximo de escritura de la unidad en TB desde el sitio del fabricante. El programa leerá el tamaño de registro actual, lo comparará con el valor máximo y calculará la vida útil restante.
Con nuestro programa puede configurar el monitoreo de estos parámetros y establecer los valores críticos del volumen de escritura del disco; al superarlos, el programa le notificará. También puede observar los valores actuales de los volúmenes registrados como porcentaje del máximo permitido en indicadores rectangulares (widgets).
Más información sobre el monitoreo SMART de HDD y SSD por red en nuestro artículo...